📅 Última actualización: 12 de abril de 2026
📅 Actualizado: febrero 2026
- Machine Learning en agricultura: qué problemas resuelve
- Preparación de datos de sensores para ML
- Modelo uno: predicción inteligente de riego
- Modelo dos: detección temprana de plagas con visión artificial
- Modelo tres: predicción de rendimiento de cosecha
- Modelo cuatro: clasificación de calidad del fruto
- Despliegue en Raspberry Pi con TensorFlow Lite
- Análisis NDVI con imágenes de dron
- MLOps para el campo: reentrenamiento automático
- Tres casos prácticos con resultados medibles
- Preguntas frecuentes
Machine Learning en agricultura: qué problemas resuelve
Machine Learning (aprendizaje automático) es la rama de la inteligencia artificial que permite a un programa aprender patrones a partir de datos históricos y hacer predicciones sobre datos nuevos. En agricultura, los problemas que resuelve son concretos y medibles: predecir cuándo y cuánto regar basándose en el comportamiento pasado del suelo, detectar enfermedades en hojas antes de que el ojo humano las vea, estimar el rendimiento de la cosecha semanas antes de la recolección y clasificar automáticamente la calidad del fruto para optimizar la cadena de valor.
Lo que hace esto especialmente relevante para el agricultor que ya tiene sensores IoT instalados (como los que montamos en nuestros tutoriales de riego con ESP32) es que ya dispone de datos. Cada lectura de temperatura, humedad del suelo, lluvia y radiación solar que tus sensores han registrado es materia prima para entrenar modelos predictivos. La diferencia entre regar con un temporizador y regar con un modelo ML que predice la necesidad hídrica de la planta a setenta y dos horas vista puede ser un ahorro del treinta al cuarenta por ciento de agua y un aumento del diez al veinte por ciento en producción.
No necesitas ser programador experto. Con Python básico y las bibliotecas que vamos a usar (scikit-learn, TensorFlow, pandas) puedes implementar modelos funcionales en unas horas. Y con TensorFlow Lite, esos modelos se ejecutan directamente en tu Raspberry Pi sin necesidad de cloud ni conexión a internet.
Preparación de datos de sensores para ML
El primer paso en cualquier proyecto de Machine Learning es preparar los datos. Si has seguido nuestro tutorial de MQTT y Node-RED o has configurado Home Assistant con InfluxDB, ya tienes datos almacenados en series temporales. Vamos a exportarlos y prepararlos para entrenar modelos.
💡 Pro Tip
La agricultura de precisión puede aumentar la productividad hasta un 25%. Explora todas nuestras guías. Ver más →
# Paso 1: Exportar datos de InfluxDB a CSV
import pandas as pd
from influxdb import InfluxDBClient

# Conectar a InfluxDB local
client = InfluxDBClient(host='localhost', port=8086, database='homeassistant')

# Consultar datos de los últimos 6 meses
query = """
 SELECT mean("value") AS valor
 FROM "°C"
 WHERE time > now() - 180d
 GROUP BY time(1h), "entity_id"
"""
result = client.query(query)

# Convertir a DataFrame de pandas
df = pd.DataFrame(result.get_points())
df['time'] = pd.to_datetime(df['time'])
df = df.set_index('time')

# Pivotar para tener una columna por sensor
df_pivot = df.pivot_table(values='valor', index='time', columns='entity_id')
print(f"Dataset: {df_pivot.shape[0]} filas x {df_pivot.shape[1]} variables")
print(df_pivot.head())
Si no tienes InfluxDB y tus datos están en archivos CSV del módulo microSD del ESP32, el proceso es igual de sencillo:
# Paso 1b: Cargar datos desde CSV del ESP32
import pandas as pd
import glob

# Leer todos los archivos CSV de la tarjeta SD
archivos = glob.glob('/media/pi/SD_CARD/datos_*.csv')
dfs = []
for archivo in archivos:
 df = pd.read_csv(archivo, parse_dates=['timestamp'])
 dfs.append(df)

datos = pd.concat(dfs, ignore_index=True)
datos = datos.sort_values('timestamp').set_index('timestamp')

# Columnas típicas de un nodo ESP32 agrícola:
# temperatura, humedad_aire, humedad_suelo, presion, lluvia_mm, luz_lux, viento_kmh
print(f"Registros: {len(datos):,}")
print(f"Periodo: {datos.index.min()} → {datos.index.max()}")
print(datos.describe())
La limpieza de datos es crucial. Los sensores agrícolas en campo producen valores atípicos: un pico de temperatura de cien grados cuando el sol incide directamente en un sensor sin garita, lecturas de humedad negativas cuando el sensor se descalibra, o huecos cuando el nodo solar se queda sin batería. Hay que detectar y tratar estos problemas antes de entrenar el modelo.
# Paso 2: Limpieza de datos agrícolas
import numpy as np

# Eliminar valores físicamente imposibles
datos.loc[datos['temperatura'] > 55, 'temperatura'] = np.nan # Máximo realista España
datos.loc[datos['temperatura'] < -15, 'temperatura'] = np.nan
datos.loc[datos['humedad_suelo'] < 0, 'humedad_suelo'] = np.nan
datos.loc[datos['humedad_suelo'] > 100, 'humedad_suelo'] = np.nan
datos.loc[datos['humedad_aire'] > 100, 'humedad_aire'] = np.nan

# Rellenar huecos con interpolación temporal
datos = datos.resample('1h').mean() # Agregar a horas
datos = datos.interpolate(method='time', limit=6) # Max 6h de interpolación

# Añadir variables derivadas (feature engineering)
datos['hora'] = datos.index.hour
datos['dia_semana'] = datos.index.dayofweek
datos['mes'] = datos.index.month
datos['temp_media_24h'] = datos['temperatura'].rolling(24).mean()
datos['humedad_suelo_delta'] = datos['humedad_suelo'].diff() # Velocidad de secado
datos['lluvia_acum_48h'] = datos['lluvia_mm'].rolling(48).sum()
datos['et0_estimada'] = 0.0023 * (datos['temperatura'] + 17.8) * np.sqrt(datos['temp_media_24h'].max() - datos['temp_media_24h'].min()) * 0.408

print(f"Variables finales: {list(datos.columns)}")
print(f"Datos limpios: {datos.dropna().shape[0]:,} registros")
Modelo uno: predicción inteligente de riego
El modelo más útil para empezar es predecir la humedad del suelo a veinticuatro, cuarenta y ocho y setenta y dos horas vista. Con esta predicción, el sistema de riego puede anticiparse: en vez de regar cuando el suelo ya está seco (reactivo), riega antes de que llegue al punto de estrés hídrico (predictivo). La diferencia en producción es significativa porque la planta nunca pasa por el ciclo de sequía-encharcamiento.
# Modelo de predicción de humedad del suelo a 24-72h
from sklearn.model_selection import train_test_split
from sklearn.ensemble import GradientBoostingRegressor
from sklearn.metrics import mean_absolute_error, r2_score
import joblib

# Variables de entrada (features)
features = [
 'temperatura', 'humedad_aire', 'humedad_suelo',
 'presion', 'lluvia_mm', 'luz_lux', 'viento_kmh',
 'hora', 'mes', 'temp_media_24h',
 'humedad_suelo_delta', 'lluvia_acum_48h', 'et0_estimada'
]

# Variable objetivo: humedad del suelo 24h después
datos['objetivo_24h'] = datos['humedad_suelo'].shift(-24)
datos['objetivo_48h'] = datos['humedad_suelo'].shift(-48)
datos['objetivo_72h'] = datos['humedad_suelo'].shift(-72)

# Preparar datos limpios
df_ml = datos[features + ['objetivo_24h']].dropna()
X = df_ml[features]
y = df_ml['objetivo_24h']

# División temporal (no aleatoria, para series temporales)
split_idx = int(len(X) * 0.8)
X_train, X_test = X[:split_idx], X[split_idx:]
y_train, y_test = y[:split_idx], y[split_idx:]

# Entrenar modelo Gradient Boosting
modelo = GradientBoostingRegressor(
 n_estimators=200,
 max_depth=5,
 learning_rate=0.1,
 min_samples_leaf=10,
 random_state=42
)
modelo.fit(X_train, y_train)

# Evaluar
y_pred = modelo.predict(X_test)
mae = mean_absolute_error(y_test, y_pred)
r2 = r2_score(y_test, y_pred)
print(f"MAE: {mae:.1f}% humedad")
print(f"R²: {r2:.3f}")

# Importancia de variables
importancia = pd.Series(modelo.feature_importances_, index=features)
print("\nVariables más importantes:")
print(importancia.sort_values(ascending=False).head(5))

# Guardar modelo para Raspberry Pi
joblib.dump(modelo, 'modelo_riego_24h.pkl')
print("\n✅ Modelo guardado: modelo_riego_24h.pkl")
Un modelo bien entrenado con tres a seis meses de datos consigue un R² de cero coma noventa y dos a cero coma noventa y seis y un error medio de dos a cuatro puntos porcentuales de humedad. Eso significa que si el modelo predice que mañana la humedad del suelo estará al treinta y ocho por ciento, el valor real estará entre treinta y cuatro y cuarenta y dos por ciento. Suficiente precisión para tomar decisiones de riego mucho mejores que un temporizador fijo.
Modelo dos: detección temprana de plagas con visión artificial
La visión artificial permite detectar enfermedades en hojas antes de que sean visibles al ojo humano o cuando la infección está en fase inicial y aún es tratable. Usamos un modelo de clasificación de imágenes entrenado con Transfer Learning sobre MobileNetV2, una red neuronal ligera que se ejecuta en Raspberry Pi.
# Detección de plagas con Transfer Learning - MobileNetV2
import tensorflow as tf
from tensorflow.keras.applications import MobileNetV2
from tensorflow.keras.layers import Dense, GlobalAveragePooling2D, Dropout
from tensorflow.keras.models import Model
from tensorflow.keras.preprocessing.image import ImageDataGenerator

# Clases para cultivos mediterráneos
clases = [
 'sana', # Hoja sana
 'oidio', # Oídio (polvo blanco)
 'mildiu', # Mildiu (manchas amarillas)
 'botritis', # Botritis (moho gris)
 'arana_roja', # Araña roja (puntos amarillos)
 'carencia_hierro',# Clorosis férrica (amarilleo)
 'carencia_nitro', # Deficiencia nitrógeno
 'estres_hidrico' # Estrés hídrico (marchitez)
]

# Base model preentrenado (ImageNet)
base_model = MobileNetV2(
 weights='imagenet',
 include_top=False,
 input_shape=(224, 224, 3)
)
base_model.trainable = False # Congelar capas base

# Añadir capas de clasificación agrícola
x = base_model.output
x = GlobalAveragePooling2D()(x)
x = Dense(128, activation='relu')(x)
x = Dropout(0.3)(x)
output = Dense(len(clases), activation='softmax')(x)

modelo_plagas = Model(inputs=base_model.input, outputs=output)
modelo_plagas.compile(
 optimizer='adam',
 loss='categorical_crossentropy',
 metrics=['accuracy']
)

# Data augmentation (crucial con pocas imágenes)
train_gen = ImageDataGenerator(
 rescale=1./255,
 rotation_range=40,
 width_shift_range=0.2,
 height_shift_range=0.2,
 horizontal_flip=True,
 zoom_range=0.2,
 brightness_range=[0.8, 1.2],
 validation_split=0.2
)

# Estructura de carpetas: /dataset/sana/, /dataset/oidio/, etc.
# Con 50-100 fotos por clase es suficiente gracias al transfer learning
train = train_gen.flow_from_directory(
 'dataset_hojas/',
 target_size=(224, 224),
 batch_size=16,
 class_mode='categorical',
 subset='training'
)

# Entrenar
history = modelo_plagas.fit(train, epochs=20, validation_data=val)
print(f"Accuracy entrenamiento: {history.history['accuracy'][-1]:.1%}")
print(f"Accuracy validación: {history.history['val_accuracy'][-1]:.1%}")
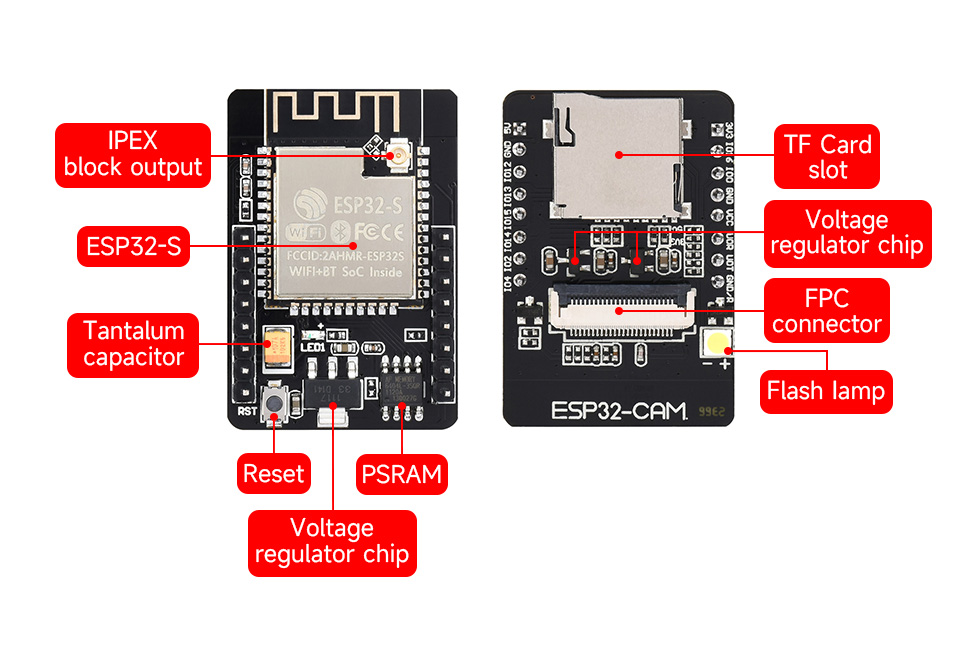
Con cincuenta a cien fotos por clase y Transfer Learning, los modelos de detección de plagas alcanzan un noventa a noventa y cinco por ciento de precisión. Las fotos las puedes tomar con tu móvil o con la cámara ESP32-CAM. Para montar un dataset rápido, recoge hojas con diferentes problemas durante la temporada, fotográfialas sobre fondo uniforme y etiquétalas en carpetas. No necesitas miles de imágenes porque MobileNetV2 ya ha aprendido a reconocer texturas, colores y formas en ImageNet.
Modelo tres: predicción de rendimiento de cosecha
Predecir el rendimiento de la cosecha semanas antes de la recolección permite planificar logística, negociar precios con compradores y ajustar tratamientos. El modelo usa datos acumulados de toda la temporada: integral térmica (grados-día acumulados), precipitación acumulada, horas de sol, aplicaciones de riego y estado fenológico del cultivo.
# Predicción de rendimiento con Random Forest
from sklearn.ensemble import RandomForestRegressor

# Variables acumuladas por campaña
features_cosecha = [
 'grados_dia_acum', # Integral térmica
 'lluvia_acum_temporada', # Precipitación total
 'riego_acum_m3', # Riego aplicado
 'horas_sol_acum', # Horas de sol
 'temp_media_temporada', # Temperatura media
 'heladas_count', # Número de heladas
 'viento_max_temporada', # Viento máximo registrado
 'humedad_suelo_media', # Humedad suelo media
 'ndvi_medio', # NDVI medio de dron (si disponible)
 'variedad', # Variedad de cultivo (codificada)
 'edad_planta', # Años de la plantación
]

# Objetivo: kg por hectárea
modelo_cosecha = RandomForestRegressor(
 n_estimators=100,
 max_depth=8,
 random_state=42
)
modelo_cosecha.fit(X_train, y_train)

# Ejemplo: predicción para olivar
prediccion = modelo_cosecha.predict([[
 2800, # grados día
 350, # mm lluvia
 1200, # m³ riego
 2400, # horas sol
 18.5, # temp media °C
 3, # heladas
 65, # viento max km/h
 42, # humedad suelo %
 0.55, # NDVI
 1, # variedad Picual
 15, # años
]])
print(f"Predicción rendimiento: {prediccion[0]:.0f} kg/ha")
Para este modelo necesitas datos históricos de varias campañas. Si llevas tres o más años registrando datos meteorológicos y conoces los rendimientos de cada campaña, puedes entrenar un modelo útil. El R² típico con cinco o más campañas de datos es cero coma ochenta y cinco a cero coma noventa y dos, lo que permite estimar la cosecha con un error del diez al quince por ciento, suficiente para planificación comercial.
Modelo cuatro: clasificación de calidad del fruto
La clasificación automática de frutos por calidad es una de las aplicaciones más rentables de la visión artificial en agricultura. Una cámara sobre la cinta de selección analiza cada fruto y lo clasifica en categorías (extra, primera, segunda, descarte) basándose en tamaño, color, forma y defectos superficiales. Esto elimina la subjetividad del clasificador humano y acelera el proceso.
# Clasificación de fruto con análisis de imagen
import cv2
import numpy as np

def analizar_fruto(imagen_path):
 """Análisis básico de fruto por color y forma"""
 img = cv2.imread(imagen_path)
 hsv = cv2.cvtColor(img, cv2.COLOR_BGR2HSV)

 # Segmentar fruto del fondo
 mask = cv2.inRange(hsv, (0, 50, 50), (180, 255, 255))
 contours, _ = cv2.findContours(mask, cv2.RETR_EXTERNAL, cv2.CHAIN_APPROX_SIMPLE)

 if not contours:
 return None

 # Contorno más grande = fruto
 fruto = max(contours, key=cv2.contourArea)
 area = cv2.contourArea(fruto)
 perimetro = cv2.arcLength(fruto, True)

 # Circularidad (1.0 = círculo perfecto)
 circularidad = 4 * np.pi * area / (perimetro ** 2) if perimetro > 0 else 0

 # Color medio del fruto
 mask_fruto = np.zeros(img.shape[:2], dtype=np.uint8)
 cv2.drawContours(mask_fruto, [fruto], -1, 255, -1)
 color_medio = cv2.mean(hsv, mask=mask_fruto)[:3]

 # Detectar defectos (manchas oscuras)
 gray = cv2.cvtColor(img, cv2.COLOR_BGR2GRAY)
 _, defectos = cv2.threshold(gray, 60, 255, cv2.THRESH_BINARY_INV)
 defectos = cv2.bitwise_and(defectos, mask_fruto)
 pct_defectos = np.sum(defectos > 0) / np.sum(mask_fruto > 0) * 100

 return {
 'area_px': area,
 'circularidad': round(circularidad, 3),
 'hue_medio': round(color_medio[0], 1),
 'saturacion': round(color_medio[1], 1),
 'defectos_pct': round(pct_defectos, 1),
 }

# Clasificar según reglas del sector
def clasificar_calidad(analisis):
 if analisis['defectos_pct'] < 2 and analisis['circularidad'] > 0.85:
 return 'EXTRA'
 elif analisis['defectos_pct'] < 5 and analisis['circularidad'] > 0.75:
 return 'PRIMERA'
 elif analisis['defectos_pct'] < 15:
 return 'SEGUNDA'
 else:
 return 'DESCARTE'
Despliegue en Raspberry Pi con TensorFlow Lite
Los modelos entrenados en un PC potente necesitan convertirse a TensorFlow Lite para ejecutarse eficientemente en la Raspberry Pi. TF Lite reduce el tamaño del modelo y optimiza las operaciones para procesadores ARM. Un modelo MobileNetV2 que ocupa catorce megabytes en TensorFlow estándar baja a cuatro megabytes en TF Lite y ejecuta inferencias en menos de cien milisegundos.
# Convertir modelo a TensorFlow Lite
converter = tf.lite.TFLiteConverter.from_keras_model(modelo_plagas)
converter.optimizations = [tf.lite.Optimize.DEFAULT] # Cuantización
tflite_model = converter.convert()

with open('modelo_plagas.tflite', 'wb') as f:
 f.write(tflite_model)
print(f"Modelo TFLite: {len(tflite_model)/1024/1024:.1f} MB")

# ═══ En la Raspberry Pi ═══
import tflite_runtime.interpreter as tflite
from PIL import Image

# Cargar modelo
interpreter = tflite.Interpreter(model_path='modelo_plagas.tflite')
interpreter.allocate_tensors()
input_details = interpreter.get_input_details()
output_details = interpreter.get_output_details()

def predecir_plaga(imagen_path):
 # Preprocesar imagen
 img = Image.open(imagen_path).resize((224, 224))
 img_array = np.array(img, dtype=np.float32) / 255.0
 img_array = np.expand_dims(img_array, axis=0)

 # Inferencia
 interpreter.set_tensor(input_details[0]['index'], img_array)
 interpreter.invoke()
 output = interpreter.get_tensor(output_details[0]['index'])[0]

 # Resultado
 clase_idx = np.argmax(output)
 confianza = output[clase_idx]
 return clases[clase_idx], confianza

resultado, conf = predecir_plaga('foto_hoja.jpg')
print(f"Diagnóstico: {resultado} ({conf:.1%} confianza)")
Análisis NDVI con imágenes de dron
El NDVI (Normalized Difference Vegetation Index) es el índice más usado en agricultura de precisión para evaluar la salud de los cultivos. Varía de menos uno a uno: valores altos (cero coma seis a cero coma nueve) indican vegetación vigorosa, valores medios (cero coma tres a cero coma seis) vegetación moderada o estresada, y valores bajos (menos de cero coma tres) suelo desnudo o vegetación muerta.
Con un dron DJI (como los que recomendamos en la guía de drones agrícolas) y procesamiento en Python, puedes generar mapas NDVI de tu finca. Los drones de consumo no tienen cámara NIR (infrarrojo cercano), pero existe una alternativa: el VARI (Visible Atmospherically Resistant Index) que usa solo el espectro visible.
# Cálculo de VARI (alternativa NDVI para cámaras RGB)
import cv2
import numpy as np
import matplotlib.pyplot as plt

# Cargar ortofoto generada con OpenDroneMap
img = cv2.imread('ortofoto_finca.tif')
img_rgb = cv2.cvtColor(img, cv2.COLOR_BGR2RGB).astype(np.float32)

R = img_rgb[:,:,0]
G = img_rgb[:,:,1]
B = img_rgb[:,:,2]

# VARI = (Green - Red) / (Green + Red - Blue)
denominador = G + R - B
denominador[denominador == 0] = 0.001 # Evitar división por cero
vari = (G - R) / denominador
vari = np.clip(vari, -1, 1)

# Visualizar mapa de salud
plt.figure(figsize=(14, 10))
plt.imshow(vari, cmap='RdYlGn', vmin=-0.3, vmax=0.5)
plt.colorbar(label='VARI (salud vegetación)')
plt.title('Mapa de salud del cultivo - VARI')
plt.savefig('mapa_vari_finca.png', dpi=150, bbox_inches='tight')

# Estadísticas por zona
umbral_estres = 0.1
zona_estres = np.sum(vari < umbral_estres) / vari.size * 100
print(f"Superficie con estrés: {zona_estres:.1f}%")
print(f"VARI medio: {np.nanmean(vari):.3f}")
MLOps para el campo: reentrenamiento automático
Los modelos de ML no son estáticos. Las condiciones cambian entre temporadas (nuevo riego, cambio de variedad, clima diferente) y los modelos necesitan actualizarse con datos recientes. Un sistema básico de MLOps (operaciones de Machine Learning) para el campo incluye un script que se ejecuta mensualmente en la Raspberry Pi, descarga los últimos datos de InfluxDB, reentrena el modelo y lo reemplaza automáticamente si el nuevo modelo es mejor que el anterior.
# Script de reentrenamiento automático (cron mensual)
import joblib
from sklearn.metrics import r2_score

def reentrenar_modelo():
 # Cargar datos actualizados
 datos_nuevos = cargar_datos_influxdb(meses=6)
 datos_limpios = limpiar_datos(datos_nuevos)
 X, y = preparar_features(datos_limpios)

 # Entrenar nuevo modelo
 modelo_nuevo = GradientBoostingRegressor(n_estimators=200, max_depth=5)
 modelo_nuevo.fit(X_train, y_train)
 r2_nuevo = r2_score(y_test, modelo_nuevo.predict(X_test))

 # Comparar con modelo actual
 modelo_actual = joblib.load('modelo_riego_24h.pkl')
 r2_actual = r2_score(y_test, modelo_actual.predict(X_test))

 if r2_nuevo > r2_actual:
 joblib.dump(modelo_nuevo, 'modelo_riego_24h.pkl')
 enviar_telegram(f"🧠 Modelo actualizado: R² {r2_actual:.3f} → {r2_nuevo:.3f}")
 else:
 enviar_telegram(f"🧠 Modelo actual sigue siendo mejor: {r2_actual:.3f} vs {r2_nuevo:.3f}")

# Añadir al crontab de la Raspberry:
# 0 3 1 * * python3 /home/pi/ml/reentrenar.py
Tres casos prácticos con resultados medibles
Caso uno: Viñedo en Ribera del Duero — riego predictivo ML
Un viticultor con ocho hectáreas llevaba dos años registrando datos con cuatro nodos ESP32 (humedad suelo, temperatura, lluvia) conectados a Home Assistant vía LoRa. Con esos datos entrenó un modelo de predicción de humedad del suelo a setenta y dos horas que alcanzó un R² de cero coma noventa y cuatro. El riego pasó de reactivo (activar cuando el suelo baja del treinta por ciento) a predictivo (regar dos días antes de que llegue al punto crítico). Resultado: veintiocho por ciento menos de agua consumida y un incremento del doce por ciento en grado alcohólico probable de la uva, lo que se tradujo en un aumento de cero coma quince euros por kilo en el precio de venta a bodega.
Caso dos: Invernadero de tomates en Almería — detección de plagas
Un productor de tomate cherry en invernadero instaló tres ESP32-CAM enfocando a las hojas de tres zonas del invernadero. Cada seis horas las cámaras capturaban imágenes que el modelo MobileNetV2 analizaba en una Raspberry Pi 4. El sistema detectó un brote de oídio dos días antes de que el técnico lo viera en la inspección semanal. El tratamiento temprano ahorró una aplicación generalizada de fungicida (ciento ochenta euros) y evitó la pérdida de producción estimada en mil doscientos euros. Inversión total del sistema: trescientos cincuenta euros.
Caso tres: Olivar ecológico en Jaén — predicción de cosecha
Una cooperativa con doscientas hectáreas de olivar ecológico llevaba seis campañas registrando datos meteorológicos. Con el modelo Random Forest de predicción de cosecha, en septiembre (dos meses antes de la recolección) pudieron estimar la producción con un error del once por ciento. Esto les permitió negociar contratos de venta anticipada con la almazara a un precio fijado quince por ciento superior al de mercado spot, porque la almazara valoraba la seguridad de suministro. Beneficio adicional por campaña: unos cuarenta mil euros para la cooperativa.
| Caso | Modelo ML | Datos necesarios | R² / Accuracy | Beneficio principal |
|---|---|---|---|---|
| Viñedo Ribera | Gradient Boosting (riego) | 2 años sensores | R² 0.94 | -28% agua, +12% grado |
| Invernadero Almería | MobileNetV2 (plagas) | 300 fotos etiquetadas | 93% accuracy | Detección 2 días antes |
| Olivar Jaén | Random Forest (cosecha) | 6 campañas | R² 0.89 | +15% precio venta |
Preguntas frecuentes
💡 ¿Qué sensores IoT se usan en agricultura?
Miden humedad del suelo, temperatura y pH. Envían datos en tiempo real y automatizan el riego.
¿Necesito saber programar para usar Machine Learning en agricultura?
Necesitas Python básico: variables, bucles y funciones. Las bibliotecas como scikit-learn hacen el trabajo pesado. Con los ejemplos de esta guía y un curso online de Python de diez a veinte horas puedes implementar tu primer modelo funcional en un fin de semana.
¿Cuántos datos necesito para entrenar un modelo útil?
Para predicción de riego, un mínimo de tres meses de datos horarios (unas dos mil filas). Para detección de plagas, cincuenta a cien fotos por clase con data augmentation. Para predicción de cosecha, mínimo tres a cinco campañas completas. Más datos siempre mejoran el modelo.
¿Puede una Raspberry Pi ejecutar modelos de Machine Learning?
Sí. Con TensorFlow Lite, una Raspberry Pi 4 ejecuta inferencia de MobileNetV2 en menos de cien milisegundos. Para modelos scikit-learn como Gradient Boosting, la predicción es prácticamente instantánea (uno a cinco milisegundos). El entrenamiento sí conviene hacerlo en un PC potente.
¿Machine Learning sustituye al agrónomo?
No. Machine Learning es una herramienta que amplifica el conocimiento del agrónomo. El modelo detecta patrones en datos que el humano no puede procesar, pero el agrónomo aporta el contexto agronómico, valida los resultados y toma las decisiones finales. La combinación de ambos es mucho más potente que cualquiera por separado.
Componentes necesarios
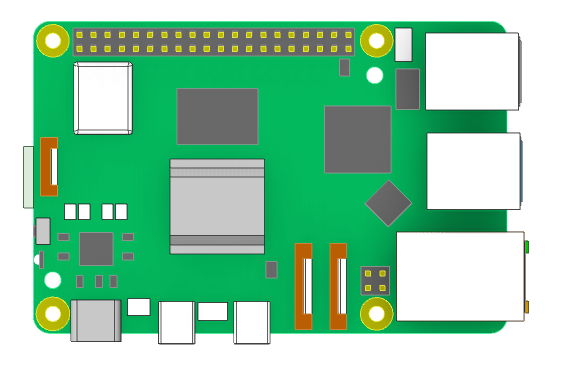
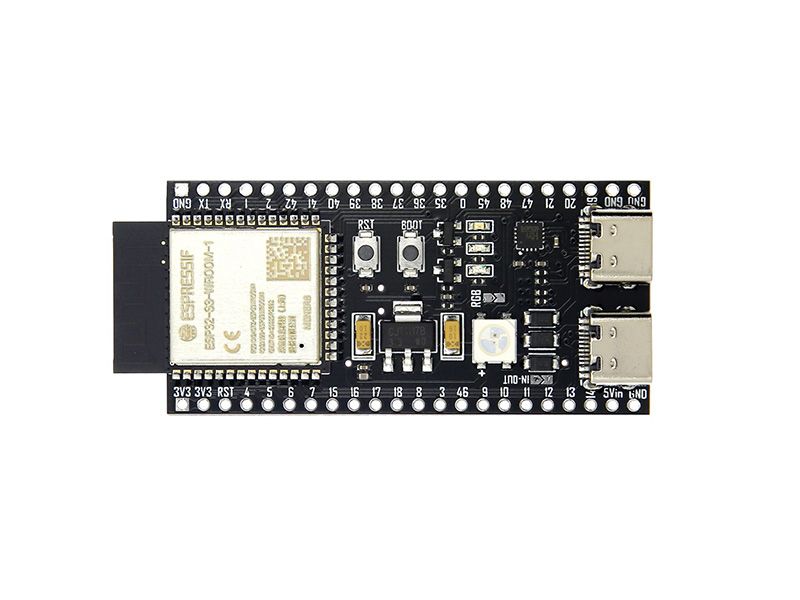
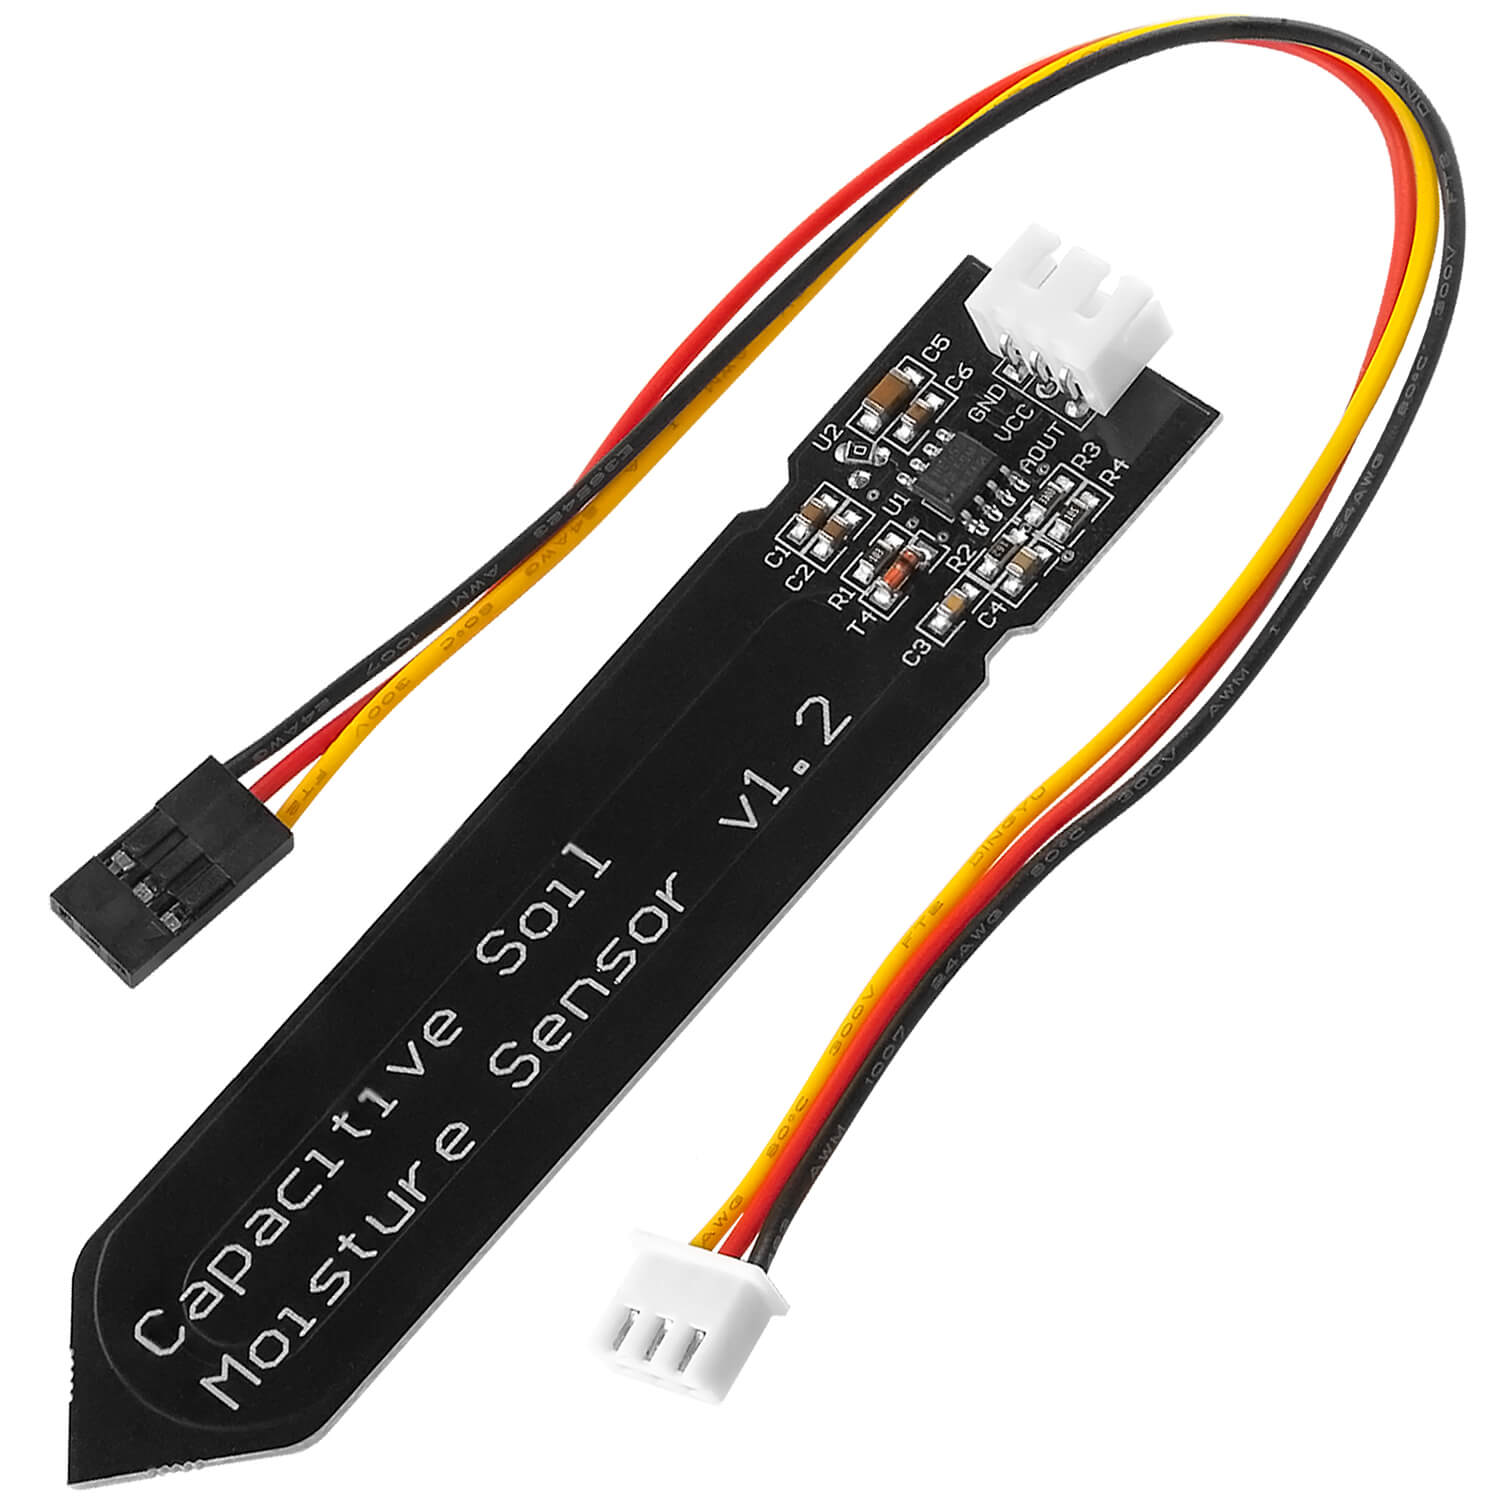
Para implementar Machine Learning en tu finca necesitas sensores que generen datos y una Raspberry Pi que ejecute los modelos. Encuentra todo en nuestra tienda:
🧠 Raspberry Pi 4 y ESP32
🌡️ Sensores Meteorológicos
💧 Sensores Humedad Suelo
📷 Cámaras para Visión Artificial
🛸 Drones para NDVI
📚 Artículos relacionados
- Tendencias AgTech 2026: Futuro de la Agricultura con IA
- Ayudas PAC 2026: Guía Completa para Agricultores
- Análisis de la Competencia en Inteligencia Artificial en Agricultura en Dos Mil Veintiséis: Principales Competidores y Oportunidades Estratégicas
- Cómo Instalar Tu Estación Meteorológica Agrícola Paso a Paso
🌱 Más sobre AgriculturaIA
Daniel Bellido
Autónomo especializado en inteligencia artificial aplicada y digitalización del sector agrario. Escribe y verifica el contenido de AgriculturaIA con fuentes oficiales.
Deja una respuesta